Часть 2: Описательная статистика, мера центральной тенденции
Итак, в нашей предыдущей статье мы обсудили основные строительные блоки статистики, и я надеюсь, что все получили четкое представление об этих концепциях. Теперь, когда мы знакомы с основами, давайте углубимся в другие концепции.
Как мы обсуждали в прошлой статье, описательная статистика — это раздел статистики, который занимается организацией и обобщением данных. Описательную статистику можно разделить на два подраздела:
- Мера центральной тенденции.
- Мера рассеивания.
Мера центральной тенденции
Мера центральной тенденции — это не что иное, как одно значение, которое определяет центральную точку всего набора данных. Есть три общих показателя центральной тенденции. Они есть
- Иметь в виду
- медиана
- Режим
Давайте рассмотрим один за другим.
1 . Среднее арифметическое
Как мы узнали из младших классов, среднее арифметическое — это не что иное, как среднее значение группы значений. Статистически это среднее значение выборки или совокупности. то есть,
например, x = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10} Здесь значение среднего является средним значением всех данных внутри x
среднее значение = (1 + 2 + 3 + 4 + 5 + 6 + 7 + 8 + 9 + 10)/10 = 5,5, поэтому в этом случае среднее значение x равно 5,5.
Как мы уже говорили ранее, есть два типа среднего. Они есть
- Среднее значение населения (μ) : среднее значение всего населения.
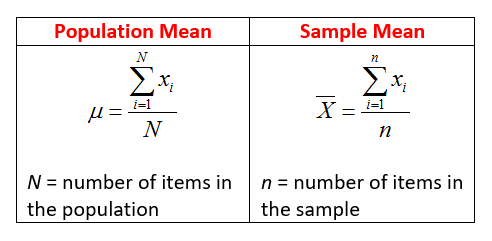
- Среднее значение выборки (x̄) : среднее значение всей выборки.
Теперь давайте рассмотрим случай, когда мы заменяем 10 в том же наборе данных на 100. Тогда это станет
х = {1, 2, 3, 4, 5, 6, 7, 8, 9, 100} | среднее = 145/110 = 14,5
Итак, что именно произошло здесь, когда единственное значение (10) изменилось на 100. Здесь центральная тенденция только что сместилась на 14,5 с предыдущего значения 4,5. Значение 100, которое сильно отличается от определенного распределения значений и не совпадает с ним, называется выбросом. Таким образом, среднее значение нельзя использовать в качестве идеального метода для определения меры центральной тенденции в некоторых случаях, когда в данных присутствуют выбросы. Поэтому в подобных случаях мы используем медиану.
«Практический пример использования: при очистке данных в некоторых полях отсутствуют значения. Чтобы обработать эти пропущенные значения в числовом поле, мы можем взять среднее значение всех данных и заменить нулевые значения, используя среднее значение. ’’
2 . Медиана
Медиана — это следующий метод вычисления меры центральной тенденции. В приведенном выше случае среднее не работает в тех обстоятельствах, когда в данных присутствуют выбросы, поэтому для обработки таких сценариев мы используем медиану.
Как следует из названия, медиана — это не что иное, как среднее значение или значения.
Да, давайте разберемся на примере.
х = {1,2,3,4,5,6,7,8,100}. Здесь среднее значение x равно 5. Здесь интересно отметить, что даже если в распределении был выброс, он не влиял на меру центральной тенденции. Вот почему медиана предпочтительнее среднего значения в качестве меры центральной тенденции.
Есть два сценария, когда мы имеем дело с медианой. то есть общее количество элементов в распределении может быть нечетным и четным
- Если общее количество элементов нечетное, медиана = {(n+1)/2}-й член
- Если общее количество элементов четное, медиана = [(n/2)-й член + {(n/2)+1}-й член]/2
3. Режим
Мода - это еще один метод представления меры центральной тенденции. Режим — это просто наиболее повторяющееся значение. например,
x = {1,1,2,1,1,4,5,6}
Здесь 1 приходит 4 раза, 2 приходит 1 раз, 4 приходит 1 раз, 5 приходит 1 раз, 6 приходит 1 раз. Итак, мы можем ясно видеть, что 1 — это термин или элемент, который повторяется больше всего. Итак, в данном случае это называется модой.
«Режим в основном используется для замены нулевых значений в категориальном поле в наборе данных. Берется наиболее часто встречающееся значение этой конкретной серии и заменяется этим значением все пустые места ».
Итак, мы можем суммировать показатели центральной тенденции в соответствии с приведенной ниже таблицей.