Тот факт, что ваша модель учится на тренировочном наборе, не означает, что ее производительность на нем будет лучше.
Иногда исследователи данных сталкиваются со случаями, когда их потери при валидации ниже, чем потери при обучении. Это странное наблюдение, потому что модель учится на тренировочном наборе, поэтому она должна лучше предсказывать тренировочный набор, но мы наблюдаем более высокие потери при обучении. Есть несколько причин, по которым это может произойти, и я расскажу о наиболее распространенных в этой статье.
Причина 1: регуляризация L1 или L2
Симптомы: потери при валидации постоянно ниже, чем потери при обучении, но разрыв между ними со временем сокращается
Независимо от того, используете ли вы регуляризацию L1 или L2, вы эффективно раздуваете функцию ошибки, добавляя к ней веса модели:
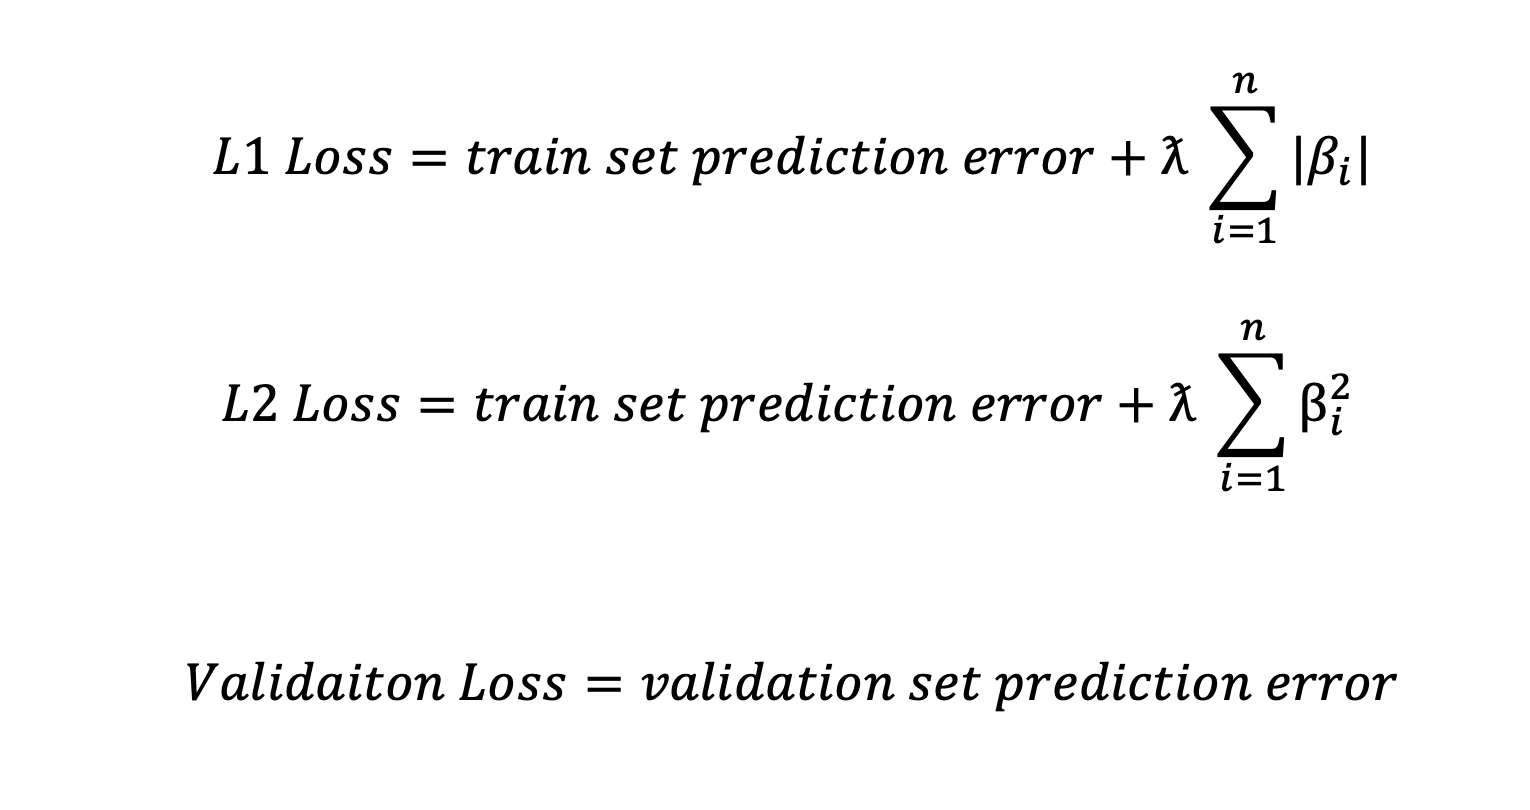
Условия регуляризации применяются только при обучении модели на тренировочном наборе, что увеличивает потери при обучении. Во время проверки и тестирования ваша функция потерь включает только ошибку прогноза, что обычно приводит к меньшим потерям, чем в обучающем наборе.
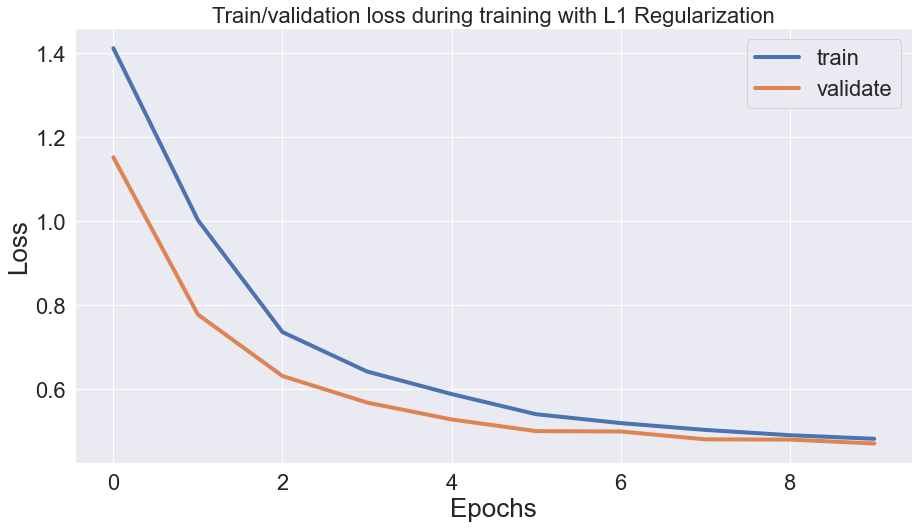
Обратите внимание, как разрыв между проверкой и потерей поезда сокращается после каждой эпохи. Это связано с тем, что по мере того, как сеть изучает данные, она также уменьшает потери при регуляризации (веса модели), что приводит к незначительной разнице между потерями при проверке и обучении.
Тем не менее, модель все еще более точна на тренировочном наборе.
Давайте сравним оценку R2 модели на обучающем и проверочном наборах:
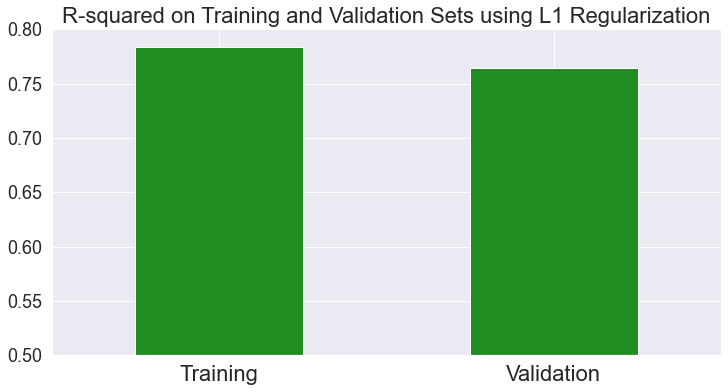
Обратите внимание, что мы не говорим о потерях и фокусируемся только на прогнозе модели для обучающих и проверочных наборов. Как и ожидалось, модель предсказывает набор поездов лучше, чем набор проверки.
Причина 2: Отсев
Симптомы: потери при валидации неизменно ниже, чем потери при обучении, разрыв между ними остается более или менее одинаковым, а потери при обучении колеблются.
Отсев наказывает дисперсию модели, случайным образом замораживая нейроны в слое во время обучения модели. Подобно регуляризации L1 и L2, отсев применим только в процессе обучения и влияет на потери при обучении, что приводит к случаям, когда потери при проверке ниже, чем потери при обучении.

В этом случае модель более точна и на тренировочном наборе:

Что ожидается. Меньшие потери не всегда приводят к более высокой точности, если в сети также есть регуляризация или отсев.
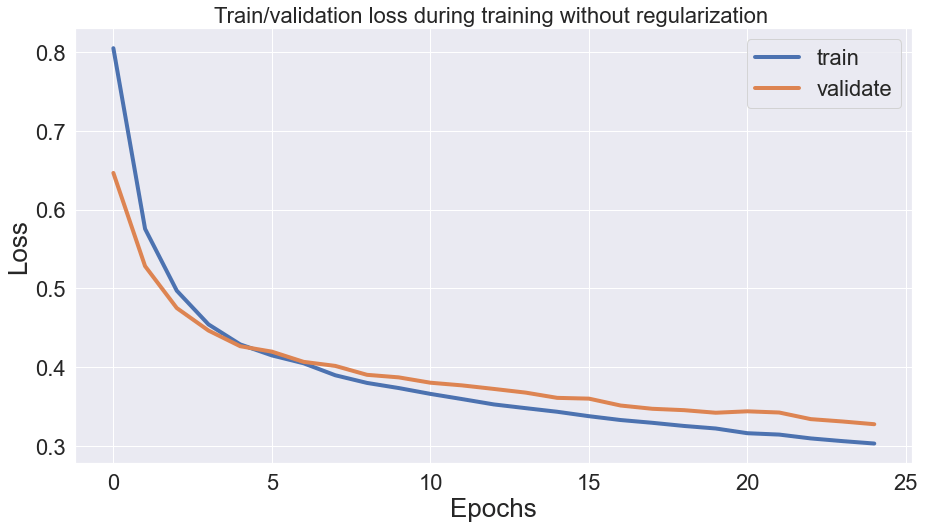
Причина 3: потери при обучении рассчитываются в течение каждой эпохи, но потери при проверке рассчитываются в конце каждой эпохи.
Симптомы: сначала потери при проверке ниже, чем потери при обучении, но позже имеют аналогичные или более высокие значения
Помните, что каждая эпоха считается завершенной, когда все обучающие данные проходят через сеть ровно один раз, и если вы передаете данные небольшими партиями, каждая эпоха может иметь несколько обратных распространений. Каждый шаг обратного распространения может значительно улучшить модель, особенно в первые несколько эпох, когда веса еще относительно не обучены.
В результате вы можете получить меньшие потери при проверке в первые несколько эпох, когда каждое обратное распространение значительно обновляет модель.
Причина 4: Чистая удача! (Применимо ко всем моделям ML)
Симптомы: проверочный набор имеет меньшие потери и более высокую точность, чем обучающий набор. У вас также не так много данных.
Помните, что шум — это вариации зависимой переменной, которые не могут объяснить независимые переменные. Когда вы выполняете разделение обучения/проверки/тестирования, у вас может быть больше шума в обучающем наборе, чем в тестовом или проверочном наборах в некоторых итерациях. Это делает модель менее точной на тренировочном наборе, если модель не переоснащается.
Если вы его используете, это можно исправить, изменив случайное начальное число в функции train_test_split (не применимо к анализу временных рядов).
Обратите внимание, что этот результат маловероятен, когда набор данных значителен из-за закона больших чисел.
Давайте проведем эксперимент и проверим чувствительность точности проверки к случайному начальному значению в функции train_test_split. Я запущу обучение модели и настройку гиперпараметров в цикле for, изменю только случайное начальное число в train_test_split и визуализирую результаты:
for i in range(10):
    X_train, X_val, y_train, y_val = train_test_split(X, Y, test_size = 0.3, random_state = i)
    xg = XGBRegressor()
    grid_obj = GridSearchCV(xg, parameters, n_jobs=-1)
    grid_obj = grid_obj.fit(X_train, y_train)
    val_r2.append(r2_score(y_val, grid_obj.predict(X_val)))
    train_r2.append(r2_score(y_train, grid_obj.predict(X_train)))

В 3 из 10 экспериментов модель имела несколько лучший показатель R2 на проверочном наборе, чем на обучающем наборе. В этом случае разумным следующим шагом будет изменение случайного начального значения на значение, которое равномерно распределяет шум между проверочным и обучающим наборами.
О сюжете можно сказать больше. Специалисты по данным обычно сосредотачиваются на настройке гиперпараметров и выборе модели, упуская из виду простые вещи, такие как случайные начальные значения, которые сильно влияют на наши результаты. Тем не менее, я напишу об этом в следующей статье!
Краткое содержание
Мы обсудили четыре сценария, которые привели к более низкой проверке, чем потеря обучения, и объяснили основную причину. Мы видели, что часто более низкие потери при проверке не обязательно приводят к более высокой точности проверки, но когда это происходит, перераспределение наборов поездов и проверок может решить проблему.
Мы провели это исследование, исходя из гипотезы, что мы не страдаем от других проблем, таких как утечка данных или систематическая ошибка выборки, поскольку они также могут привести к аналогичным наблюдениям.
Не забудьте подписаться, чтобы узнать больше!